728x90

도커를 공부하다보니 궁금한 점이 생겼다. 원하는 어플리케이션을 도커에 띄울 때 dockerFile을 사용하기도 하고 docker-compose.yml을 사용하기도 한 다. 왜 둘이 분리해놓은 것일까? 다른 점은 무엇일까?

구글링한 결과 다음과 같은 글을 볼 수 있었다.
Difference between Docker Compose Vs Dockerfile | dockerlabs

해석하면 다음과 같다.

Dockerfile은 사용자가 이미지를 어셈블하기 위해 호출할 수 있는 명령이 포함된 간단한 텍스트 파일인 반면, Docker Compose는 다중 컨테이너 Docker 애플리케이션을 정의하고 실행하기 위한 도구입니다.

Docker Compose는 앱을 구성하는 서비스를 docker-compose.yml에 정의하여 격리된 환경에서 함께 실행할 수 있습니다. docker-compose up을 실행하여 하나의 명령으로 앱을 실행합니다.
프로젝트의 docker-compose.yml에 빌드 명령을 추가하면 Docker compose는 Dockerfile을 사용합니다. Docker 워크플로는 생성하려는 각 이미지에 적합한 Dockerfile을 빌드한 다음 compose를 사용하여 build 명령을 사용하여 이미지를 조합하는 것이어야 합니다.


  • Dockerfile
    • 목적
      • 이미지를 어셈블하기 위해 호출할 수 있는 명령이 포함된 간단한 텍스트 파일
      • 단일 Docker 이미지를 빌드하기 위한 명세서
      • 이 파일에는 베이스 이미지 선택, 추가 파일 복사, 환경 변수 설정, 필요한 소프트웨어 설치, 컨테이너 실행 시 실행할 명령어 등 이미지를 생성하기 위한 모든 명령어가 포함
    • 기능
      • Docker 이미지를 생성
      • 이 이미지는 애플리케이션과 그 애플리케이션을 실행하는 데 필요한 모든 종속성을 포함
      • 이미지는 컨테이너를 생성하는 데 사용
    • 사용 예시
      • 보통 애플리케이션 개발 과정에서 특정 서비스나 애플리케이션의 빌드 방식을 정의할 때 사용
      • Node.js 애플리케이션을 위한 Dockerfile은 Node.js 환경을 설정하고 애플리케이션 코드를 이미지 내부로 복사하는 명령어를 포함할 수 있다.
  • Docker Compose
    • 목적
      • 앱을 구성하는 서비스를 docker-compose.yml에 정의하여 docker-compose up을 실행하여 하나의 명령으로 앱을 실행
      • 즉, 앱이 실행되는 동안 컨테이너를 관리하는 역할
      • 앱이 시작되면 컨테이너를 띄우고 앱이 실행되는 중에 컨테이너가 종료되면 다시 띄워줌
      • 여러 Docker 컨테이너를 정의하고 실행하기 위한 도구인 Docker Compose의 설정 파일
      • 이 파일에서는 애플리케이션을 구성하는 여러 서비스(예: 데이터베이스, 백엔드 애플리케이션, 프론트엔드 애플리케이션 등)를 정의하고, 각 서비스에 대한 이미지, 포트 매핑, 볼륨 마운트, 네트워크 설정 등을 지정
    • 기능
      • 여러 컨테이너의 배포 및 관리를 단순화
      • docker-compose 명령어를 사용하여 모든 서비스를 한 번에 시작, 중지, 재구축할 수 있다.
    • 사용 예시
      • docker-compose.yml은 마이크로서비스 아키텍처 또는 여러 종속성을 가진 복잡한 애플리케이션을 로컬 개발 환경이나 테스트 환경에서 실행할 때 주로 사용
      • 예를 들어, 웹 애플리케이션, 관련 데이터베이스, 그리고 그것들을 연결하는 네트워크를 동시에 정의하고 실행할 수 있다.
  • docker-compose.yml 파일에서 Dockerfile의 경로를 통해 Dockerfile에 정의된 이미지를 관리할 수도 있다.
  • 그래서 docker-compose.yml에서 빌드에 대한 내용이 어떻게 나타나 있는지 찾아보게 되었고 docker 공식 홈페이지에서 이런 내용을 찾아 볼 수 있었다.

Legacy versions | Docker Docs

As with docker run, options specified in the Dockerfile, such as CMD, EXPOSE, VOLUME, ENV, are respected by default - you don’t need to specify them again in docker-compose.yml.


Dockerfile에서 나타난 CMD, EXPOSE, VOLUME, ENV에 관한 내용에 따라서 빌드가 되기 때문에 이에 관련된 내용은 docker-compose.yml에서 따로 나타낼 필요는 없다.


  • docker-compose.yml에서 Dockerfile의 경로 지정
version: "3.9"
services:
  webapp:
    build: ./dir


  • Dockerfile의 args아래에 지정된 경로가 있는 경우
version: "3.9"
services:
  webapp:
    build:
      context: ./dir
      dockerfile: Dockerfile-alternate
      args:
        buildno: 1


한 줄 정리


Dockerfile : 이미지 빌드
docker-compose.yml : 앱이 실행되는 동안 컨테이너 관리

728x90
728x90
 

docker-compose 작성법에 대해서 정리하고자 한다.


1. Docker-compose

  • 여러 Docker 컨테이너를 정의하고 실행하기 위한 도구
  • yaml file 기반으로 multi container 관리할 수 있는 client이고 yaml파일에 명령어를 적어서 컨테이너를 정의하고 관리한다.
  • 여러 컨테이너가 서로 어떻게 상호 작용하는지, 네트워크와 볼륨 설정은 어떻게 되어야 하는지 등을 정의
  • 관리나 가독성 측면에서 docker-compose를 사용해 주는게 더 좋다.
  • Window에서 docker를 사용하기 위해 docker desktop을 설치하면 자동으로 docker compose가 설치 된다.
  • cmd창에서 아래 명령어로 해당 버전을 확인 할 수 있다. 
docker-compose -v 
docker -v


3. Docker-compose 작성법

version: '3'

services: // 생성하고자 하는 컨테이너들을 컨테이너이름, 설정 순으로 나열
    nginx:
        build:
            context: ./requierments/nginx // 빌드명령을 실행할 경로
            dockerfile: ./Dockerfile // 빌드를 실행할 파일
        volumes: // 컨테이너에 마운트할 볼륨 경로
            - wp:/var/www/html
        ports: // 호스트에서:같은네트워크
            - "443:443"
        networks:
            - intra
        depends_on: // 종속성 순서대로 실행될 수 있도록 설정
            - wordpress
        env_file: // 환경변수가 저장되있는 파일
            - .env 
        restart: always

    mariadb:
        build:
            context: ./requierments/mariadb
            dockerfile: ./Dockerfile
        networks:
            - intra
        volumes:
            - db:/var/lib/mysql // volumes의 db를 /var/lib/mysql와 연결하는것
        env_file:
            - .env
        restart: always

    wordpress:
        build:
            context: ./requierments/wordpress
            dockerfile: ./Dockerfile
        depends_on:
            - mariadb
        volumes:
            - wp:/var/www/html
        networks:
            - intra
        env_file:
            - .env
        restart: always

volumes:
    wp:
        driver: local // 볼륨에 사용할 볼륨 드라이버
        driver_opts: // 볼륨 드라이버에 전달할 옵션 목록
            type: none // 사용할 볼륨 드라이버 유형
            o: bind // 마운트 옵션
            device: 'home/$user_name/data/wordpress' // 호스트 파일 시스템에서 사용할 경로

    db:
        driver: local
        driver_opts:
            type: none
            o: bind
            device: 'home/$user_name/data/mariadb'

networks:
    intra:
        driver: bridge


4. Docker-compose 명령어

  • docker-compose up
    • docker-compose.yml을 바탕으로 컨테이너들을 생성하기 시작
    • -d 옵션을 사용하면 컨테이너를 백그라운드에서 실행시킴
    • --build 옵션을 사용하면 컨테이너 시작시 dockerfile을 빌드함
  • docker-compose down
    • docker-compose.yml을 바탕으로 생성한 컨테이너나 이미지들을 정지시키고 일괄적으로 삭제해줌
    • --rmi all 옵션을 사용하면 모든 이미지를 삭제함
    • -v 옵션을 사용하면 데이터 볼륨을 삭제함
  • docker-compose ps
    • 현재 작동중인 컨테이너의 목록들을 보여줌
    • -q옵션을 사용하면 컨테이너 ID만 출력
  • docker-compose stop
    • 현재 작동중인 컨테이너들을 일괄적으로 정지함
  • docker-compose start
    • 현재 정지된 컨테이너들을 일괄적으로 시작함
  • docker-compose restart
    • 현재 작동중인 컨테이너들을 일괄적으로 재시작함
  • Docker를 사용하다보면 이미지 생성중 에러가 발생시 생기는 <none> 이미지, 컨테이너가 쌓이게 됨
    • docker rm $(docker ps --filter status=exited -q)
    • docker rmi $(docker images -f "dangling=true" -q)
    • 두 명령어를 사용하면 <none> 이미지와 컨테이너를 삭제할 수 있음
728x90
728x90

동시성 이슈 (a.k.a. 따닥 이슈)

개념 및 문제점

동시성 이슈, 흔히 말하는 따닥 이슈라고 한다.
유저가 어떤 버튼을 한 순간에 여러 번 클릭하여 API 호출이 중복으로 일어나게 되면 따닥 거린다해서.....
암튼 이런 경우 비즈니스 로직에서 예외 처리를 해주어도, 여러 요청이 동시에 비즈니스 로직을 타게 되어 예외가 발생하지 않고 통과하게 된다.

따닥 이슈는 아래와 같은 문제를 발생하게 된다.
예로, 개발 중인 혜택 서비스의 경우 유저가 어떠한 액션을 수행했을 때, 이 액션에 대한 보상으로 페이포인트 리워드를 제공한다고 하자. 페이포인트는 실제 현금은 아닌데 그렇지만 현금처럼 사용할 수 있는 디지털 화폐이고, 회사 예산을 사용하기 때문에 중복으로 제공하면 안 된다. 하지만 따닥 이슈가 발생하면, 유저에게 페이포인트가 중복으로 지급되는 문제가 발생할 수 있다.

해결 방안 및 선택 이유


1차적으로는 FE에서 디바운스를 통해 동시성 이슈를 막고 있지만 100% 막을 수는 없어 서버에서도 이를 인지하고 방어해야 할 것이다. 서버에서 해결할 수 있는 방법에는 애플리케이션 단 분산 락 구현, DB 단 베타 락(쓰기 락) 사용 등이 있다.


1. 분산 락 구현

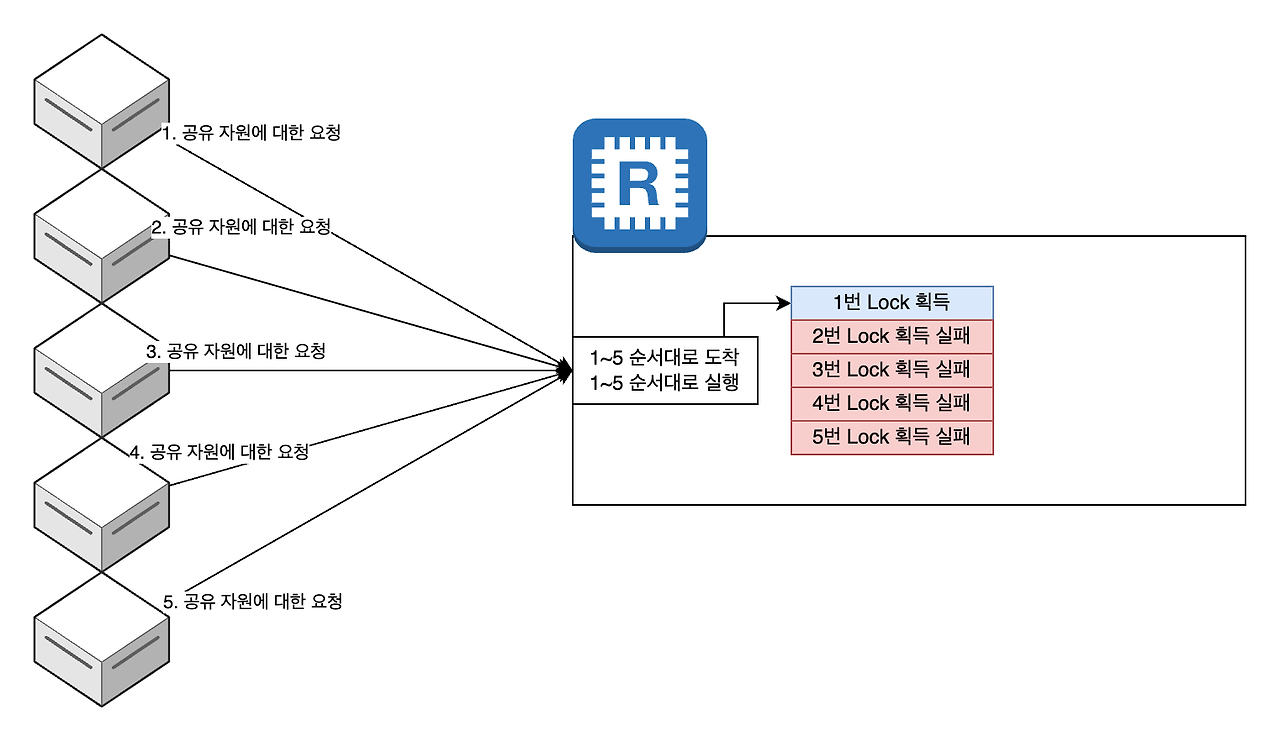
여러 서버가 공유 자원을 동시에 사용하는 경우, Redis 같은 외부 시스템을 이용해 락을 걸어 동시성 문제를 방지할 수 있다.

Redis: SETNX 명령어를 통해 락을 걸고 해제하는 분산 락 구현이 가능하다. Redisson 라이브러리를 사용하면 쉽게 Redis 기반의 락을 적용할 수 있다. 이미 기존에 키가 존재하는 경우에는 작업 수행에 실패하여 false를 반환하도록 할 수 있다. 

그리고 레디스는 단일 스레드로 작동되는 키-값 저장소이기 때문에 모든 명령은 순차적으로 처리된다. 이러한 특성으로 인해 분산락을 구현하면 다음 그림과 같다.


2. 데이터베이스 수준에서의 잠금

  • 행 잠금 (Row Locking): 특정 데이터베이스의 레코드를 잠그는 방식이다. 특정 트랜잭션이 끝날 때까지 다른 트랜잭션은 잠긴 행에 접근할 수 없다. 주로 금융 등 정합성이 중요한 경우 사용된다.
  • 비관적 잠금 (Pessimistic Locking) == 베타 락 : 트랜잭션이 데이터를 수정하려 할 때 데이터를 잠가 다른 트랜잭션이 접근하지 못하게 한다. 주로 SELECT FOR UPDATE 구문을 사용하여 잠금을 걸 수 있다.
  • 낙관적 잠금 (Optimistic Locking): 데이터를 갱신하기 전 데이터의 버전을 확인하여, 갱신하려는 동안 다른 트랜잭션이 데이터를 변경하지 않았는지 확인하는 방식이다. version 컬럼을 추가하여 버전을 검사하는 방식이 자주 사용된다.
728x90
728x90

컨테이너

컨테이너란?

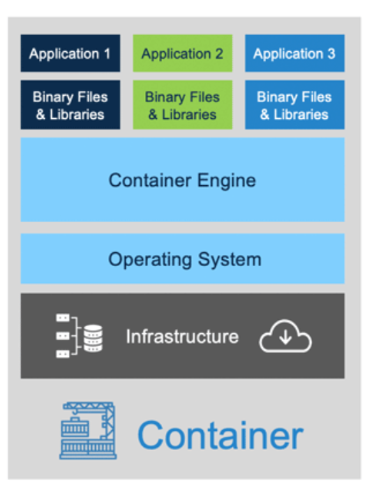
  • 어떤 환경에서나 실행하기 위해 필요한 모든 요소(의존성)를 포함하는 소프트웨어 패키지.
  • 이를 통해 전체 기능을 유지하면서 컨테이너화된 애플리케이션을 환경(개발, 테스트, 프로덕션 환경 등) 간에 쉽게 이동할 수 있다. 

컨테이너 = 마법 상자

  • 내 물건과 다른 사람의 물건이 한 군데 뒤섞이면 내 것을 찾기 힘들다.
  • 그런데 어떤 마법 상자는 A는 A의 물건만 들어있고, B는 B의 물건만 넣어서 관리해준다.
  • 마법 상자는 어디서든 똑같이 열 수 있어서 집에서든, 카페에서든 상자를 열면 내 물건이 그대로 들어있다. 게다가 가벼워서 들고 다니기도 편하다!
  • 컴퓨터에서도 프로그램을 실행할 때, 이 상자를 사용하면 어디서든 같은 환경에서 프로그램을 실행할 수 있다.
    • 컨테이너 = 마법 상자
    • 컨테이너 안에 들어 있는 프로그램 또는 데이터 = 내 물건
    • Docker = 상자를 만들기 위한 모든 도구를 제공해주는 것
    • Kubernates = 상자가 많아지면 관리가 필요한데 이 상자를 필요한 곳에 효율적으로 배치하고 관리해주는 것 


왜, 사용할까?

  • 개발 환경의 일관성
    • 호환되지 않는 환경으로 인해 발생하는 충돌을 방지하고 시스템 전반에서 일관된 성능을 얻을 수 있다.
      • “내 컴퓨터에서는 되는데?” 문제를 해결해준다.
    • 개발자는 다양한 서버 환경에 상관 없이 애플리케이션 자체에 집중할 수 있다.
  • 가상 머신에 비해 작은 크기와 빠른 속도
    • 컨테이너는 시스템 OS 커널을 공유하므로 VM과 달리 애플리케이션마다 OS 인스턴스를 둘 필요가 없다.
      • 즉, 부팅할 운영 체제가 없기 때문에 빠르게 실행할 수 있다.
  • 이식성
    • 컨테이너가 모든 종속 항목을 함께 전달하므로, 한 번 만든 소프트웨어는 재구성 없이 어떤 환경에서든 실행할 수 있다.
  • 모듈성
    • 컨테이너를 더 작은 모듈로 나누어 개별 컨테이너를 유연하게 발전시키고 확장, 재사용할 수 있다.
  • 결함 격리
    • 한 컨테이너의 장애는 다른 컨테이너의 지속적인 운영에 영향을 주지 않기 때문에 다른 컨테이너의 가동 중단 없이 한 컨테이너 내의 문제를 식별하고 정정할 수 있다. 


어디서 사용할까?

  • 개발자는 로컬 환경에서 컨테이너를 사용해 애플리케이션을 개발, 테스트할 수 있다.
    • 이때 컨테이너 안에서 애플리케이션이 실행되므로 개발 환경이 프로덕션 환경과 정확히 일치하게 된다.
  • 마이크로서비스 아키텍처
    • 마이크로서비스 아키텍처?
      • 애플리케이션을 작고 독립적인 부분으로 나누어 개발하는 것
    • 각 마이크로서비스를 개별 컨테이너에 분류해 개발자들은 전체 애플리케이션을 다시 작업하지 않고 독립적으로 업데이트할 수 있다.
  • CI/CD (지속적인 통합, 지속적인 배포)
    • 빌드, 테스트, 배포될 때마다 일관된 환경에서 실행하므로 안전성이 높아진다. 


Docker

  • 개발자가 컨테이너를 빌드, 배포, 실행, 업데이트, 관리할 수 있는 오픈 소스 플랫폼

왜 굳이 도커를 사용해 컨테이너를 만들까?

  • Linux 및 기타 OS에서 기본 제공하는 기능을 직접 사용하면 개발자가 Docker 없이 컨테이너를 생성하는 것도 가능하다. (리눅스 컨테이너 기술)
    • 하지만 Docker를 사용하면 더 빠르고 편리하며 안전하게 컨테이너를 만들 수 있다.
  • 이식성
    • 다양한 OS에서 실행될 수 있어 어느 환경에서나 동일하게 실행할 수 있다.
    • 클라우드 환경과 온프레미스 환경 간의 이동성도 높여준다.
  • 버전 관리와 재현성
    • 도커 이미지는 버전 관리가 가능해 어떤 시점의 애플리케이션 상태도 재현할 수 있다. 


구성 요소

  • 도커 엔진
    • 시스템의 핵심으로, 클라이언트 서버 아키텍처를 사용하는 애플리케이션이며 호스트 시스템에 설치된다.
    • 도커 데몬(실행 파일)이다. REST API를 통해 docker 명령어를 클라이언트와 통신한다.
    • 도커 엔진은 아래 도커 요소들을 포함한다.
  • 도커 파일(Dockerfile)
    • 모든 도커 컨테이너는 도커 컨테이너 이미지의 빌드 방법에 관한 지시사항이 포함된 단순 텍스트 파일로 시작한다.
    • 도커 파일은 도커 이미지 생성 프로세스를 자동화한다.
      • CLI 명령어 리스트로 이루어져있다.
  • 도커 이미지
    • 실행 가능한 애플리케이션 소스 코드와 이 애플리케이션이 컨테이너 형태로 실행되는 데 모든 툴, 라이브러리 및 종속성이 포함되어 있다.
    • 도커 이미지를 실행하면 컨테이너의 인스턴스가 된다.
    • 도커 이미지를 완전히 새로 빌드하거나 공통 저장소에서 이미지를 가져오기도 한다.
  • 도커 컨테이너
    • 도커 이미지의 현재 실행 중인 라이브 인스턴스이다.
    • 독립된 컨테이너는 네트워크를 통해 서로 통신할 수 있다.
  • 도커 허브
    • 도커 이미지를 공유하는 저장소


작동 과정

  1. 도커 파일 작성
    • Dockerfile은 애플리케이션을 실행하는 데 필요한 모든 지시사항을 포함한다.
      • 사용할 기반 이미지, 추가할 파일, 실행할 명령어 등이 포함된다.
  2. 이미지 빌드
    • Dockerfile을 사용해 도커 이미지를 빌드한다.
    • 도커 클라이언트는 Dockerfile에 명시된 지시사항을 순서대로 실행해 애플리케이션을 실행하는 데 필요한 모든 것을 포함하는 이미지를 생성한다.
  3. 컨테이너 생성 및 실행
    • 빌드된 이미지를 기반으로 컨테이너를 생성하고 실행한다.
    • 컨테이너를 격리된 환경에서 실행해 독립적으로 동작하도록 한다. 


정리


Container : 한 대의 서버에서 여러 개의 소프트웨어를 안전하고 효율적으로 운영 가능

Docker : 컨테이너를 관리하기 위한 도구로 일종의 프로그램

쿠버네티스 : 서버가 여러 대 있는 환경에서 각각의 서버의 도커에게 지시해주는 오케스트레이션 도구


728x90
728x90

트랜잭션

  • 트랜잭션은 데이터베이스의 상태를 변화시키기 위해 수행하는 작업의 단위
  • 데이터베이스의 상태를 변화시킨다는 말은 질의어(SQL)를 이용하여 데이터베이스에 접근하는 것
  • 한꺼번에 수행되어야 할 연산을 모아놓은 것 ⇒ 연산들을 모두 처리하지 못 한 경우에는 원 상태로 복구한다. 즉 작업의 일부만 적용되는 현상이 발생하지 않는다.
    • SELECT
    • INSERT
    • DELETE
    • UPDATE
  • ex) 게시판
    • 게시판 사용자는 게시글을 작성하고 올리기 버튼을 누른다.
    • 그 후에 다시 게시판에 돌아왔을 때, 게시판은 자신의 글이 포함된 업데이트된 게시판을 보게된다.
    • 이러한 상황을 데이터베이스 작업으로 옮기면 사용자가 올리기 버튼을 눌렀을 시 INSERT문을 사용하여 사용자가 입력한 게시글의 데이터를 옮긴다.
    • 그 후에 게시판을 구성할 데이터를 다시 SELECT 하여 최신 정보로 유지한다.
    • 여기서 작업의 단위는 INSERT, SELECT 문 둘 다를 합친 것이다. ⇒ 이러한 작업단위를 하나의 트랜잭션 이라고 한다.

트랜잭션의 특징

  • Atomicity 원자성
    • 트랜잭션이 데이터베이스에 모두 반영되거나 아니면 전혀 반영되지 않아야 한다는 것
    • 트랜잭션은 사람이 설계한 논리적인 작업 단위로서 일처리는 작업 단위 별로 이루어져야 사람이 다루는데 무리가 없다.
    • 만약 트랜잭션 단위로 데이터가 처리되지 않는다면 설계한 사람은 데이터 처리 시스템을 이해하기 힘들 뿐만 아니라 오작동 했을 시 원인을 찾기가 매우 힘들어 질 것이다.
  • Consistenty 일관성
    • 트랜잭션의 작업 처리 결과가 항상 일관성이 있어야 한다는 것이다.
    • 트랜잭션이 진행되는 동안에 데이터베이스가 변경 되더라도 업데이트 된 데이터베이스로 트랜잭션이 진행되는 것이 아니라 처음에 트랜잭션을 진행하기 위해 참조한 데이터베이스로 진행된다.
    • 이렇게 함으로써 각 사용자는 일관성 있는 데이터를 볼 수 있는 것이다.
  • Isolation 독립성, 격리성
    • 둘 이상의 트랜잭션이 동시에 실행되고 있을 경우 어떤 하나의 트랜잭션이라도 다른 트랜잭션의 연산에 끼어들 수 없다는 것을 가리킨다.
    • 하나의 특정 트랜잭션이 완료될 때까지 다른 트랜잭션이 특정 트랜잭션의 결과를 참조할 수 없다.
    • 독립성, 고립성을 구현하는 개념 ⇒ 격리수준
      • 동시에 여러 트랜잭션이 처리될 때 트랜잭션끼리 얼마나 서로 고립되어 있는지를 나타내는 것
  • Durability 지속성
    • 트랜잭션이 성공적으로 완료됐을 경우 결과는 영구적으로 반영되어야 한다는 점이다.

트랜잭션의 Commit, Rollback 연산

  • Commit
    • 트랜잭션이 성공적으로 수행되었음을 선언하는 연산
    • 하나의 트랜잭션이 성공적으로 끝났고 데이터베이스가 일관성있는 상태에 있을 때 하나의 트랜잭션이 끝났다라는 것을 알려주기 위해 사용하는 연산
  • Rollback
    • 트랜잭션 수행이 실패했음을 선언하고 작업을 취소하는 연산
    • 하나의 트랜잭션 처리가 비정상적으로 종료되어 트랜잭션의 원자성이 깨진 경우 트랜잭션을 처음부터 다시 시작하거나 트랜잭션의 부분적으로만 연산된 결과를 다시 취소시킨다.

트랜잭션의 격리수준

  • ACID 중 Isolation(독립성, 고립성)을 구현하는 개념
  • 동시에 여러 트랜잭션이 처리될 때 트랜잭션끼리 얼마나 서로 고립되어 있는지를 나타내는 것
  • 즉, 특정 트랜잭션이 다른 트랜잭션에 변경한 데이터를 볼 수 있도록 허용할지 말지를 결정하는 것
  • 격리수준은 아래의 4가지로 구분
    • READ UNCOMMITTED
    • READ COMMITED
    • REPEATABLE READ
    • SERIALIZABLE
    • 아래로 내려갈수록 트랜잭션 간 고립 정도가 높아지며 성능이 떨어지는 것이 일반적
    • 일반적인 온라인 서비스에서는 READ COMMITED나 REPEATABLE READ 중 하나를 사용
    • (oracle의 디폴트 = READ COMMITED, MySQL의 디폴트 = REPEATABLE READ)


격리수준의 필요성

  • DB는 ACID 특징과 같이 트랜잭션이 독립적인 수행을 하도록 한다.
  • 따라서 Locking을 통해 트랜잭션이 DB를 다루는 동안 다른 트랜잭션이 관여하지 못하도록 막는 것이 필요하다.
  • 하지만 무조건 Locking으로 동시에 수행되는 수많은 트랜잭션들을 순서대로 처리하는 방식으로 구현하게 되면, DB의 성능은 떨어지게 된다.
  • 그렇다고 성능을 높이기 위해 Locking의 범위를 줄인다면 잘못된 값이 처리될 문제가 발생하게 되므로, 최대한 효율적인 Locking 방법이 필요하다.


트랜잭션 격리수준의 종류

READ UNCOMMITTED (레벨 0) - 커밋되지 않는 읽기

  • 각 트랜잭션에서의 변경 내용을 COMMIT 이나 ROLLBACK 여부에 상관없이 다른 트랜잭션에서 값을 읽을 수 있다.
  • 정합성에 문제가 많은 격리 수준이기 때문에 사용하지 않는 것을 권장.
  • DIRTY READ 현상 발생 ⇒ 더러운 읽기 발생
    • DIRTY READ: 트랜잭션 작업이 완료되지 않았음에도 다른 트랜잭션에서 볼 수 있게 됨

READ COMMITED (레벨 1) - 커밋된 읽기

  • RDB에서 대부분 기본적으로 사용되고 있는 격리 수준
  • 실제 테이블 값을 가져오는 것이 아니라, Undo 영역에 백업된 레코드에서 값을 가져옴
  • DIRTY READ와 같은 현상 발생 X
  • Non-repeatable Read 현상 발생
    • Non-repeatable Read: 한 트랜잭션에서 같은 쿼리를 두 번 수행할 때, 그 사이에 다른 트랜잭션 값을 수정 or 삭제하면서 두 쿼리의 결과가 상이하게 나타나는 일관성이 깨진 현상

REPEATABLE READ (레벨 2) - 반복가능한 읽기

  • Undo 공간에 백업해두고 실제 레코드 값을 변경
  • MySQL에서는 트랜잭션마다 트랜잭션 ID를 부여해 트랜잭션 ID보다 작은 번호에서 변경한 것만 읽음
  • 백업된 데이터는 불필요하다고 판단하는 시점에 주기적으로 삭제
  • Undo에 백업된 레코드가 많아지면 MySQL 서버의 처리 성능이 떨어질 수 있음
  • 이러한 변경방식을 MVCC(Multi Version Concurrency Control) 라고 부름
  • PHANTOM READ 현상 발생
    • PHANTOM READ: 다른 트랜잭션에서 수행한 변경 작업에 의해 레코드가 보였다가 안 보였다가 하는 현상
    • REPEATABLE READ 에 의하면 원래 출력되지 않아야 하는데 Update 영향을 받은 후부터 출력
    • 방지 방법: 쓰기(write) 잠금을 걸어야 함

SERIALIZABLE (레벨 3) - 직렬화 가능

  • 가장 단순한 격리 수준이면서 가장 엄격한 격리 수준
  • 완벽한 읽기 일관성 모드 제공
  • 다른 사용자는 트랜잭션 영역에 해당되는 데이터에 대한 수정 및 입력 불가능
  • 성능 측면에서는, 동시 처리 성능 가장 낮음
  • PHANTOM READ 발생 X
  • DB에서 거의 사용 X

정리 :: 낮은 격리수준을 활용했을 때 발생하는 현상들

이 현상들은 트랜잭션의 Isolation(고립성)과 데이터 무결성의 지표로 사용된다.

  1. Dirty Read트랜잭션이 종료되면 더이상 존재하지 않거나, 롤백되었거나, 저장 위치가 바뀌었을 수도 있는 데이터를 읽어들이는 현상
  2. 생성, 갱신 또는 삭제 중에 커밋되지 않은 데이터 조회를 허용함으로써,
  3. Non-repeatable Readex) A와 B가 마지막 남은 영화표를 예매하는데, A가 고민하는 중에 B가 표를 구매하여 A는 상반된 정보를 받게 되는 경우
  4. 한 트랜잭션 내에서 같은 행이 두 번 이상 조회됐는데 그 값이 다른 경우
  5. Phantom Read첫 번째 쿼리에서 없던 레코드가 두 번째 쿼리에서 나타나는 현상
728x90
728x90

RedissonClient는 데이터베이스, 캐시, 메시지 브로커 등 일반적으로 사용되는 오픈 소스 인메모리 데이터 구조인 Redis에 사용할 수 있는 자바 클라이언트 라이브러리입니다. RedisClient는 Redis와 함께 사용하는데 도움을 주는 고급 인터페이스를 제공하는데, 분산 잠금, 스케줄링 등 기능을 제공합니다.

저는 RedisClient의 분산락 기능을 활용하여 해당 문제를 해결하였습니다.


먼저, Spring에서 RedisClient를 사용하기 위해서는 해당 라이브러리 의존성을 주입하고 config 설정을 해야 합니다.


implementation 'org.redisson:redisson-spring-boot-starter:3.17.7'
@Configuration
public class RedissonConfig {

    @Bean
    public RedissonClient redissonClient() {
        Config config = new Config();
        config.useSingleServer().setAddress("redis://localhost:6381");
        return Redisson.create();
    }
}


RedissonClient에서 분산락 설정을 위해 사용한 기능은 아래와 같습니다.


RLock: RLock은 여러 스레드 또는 프로세스 간에 공유 리소스에 대한 액세스를 동기화하는 방법을 제공하는 Redisson 분산락 기능입니다. 


lock.tryLock(): RLock의 tryLock() 메서드는 즉시 잠금을 획득하려고 시도하여 잠금을 획득한 경우, true를 반환하고, 잠금을 획득하지 않은 경우 false를 반환합니다.


lock.unlock(): 해당 메소드는 이전에 획득한 잠금을 해제합니다. 보통 try-catch-finally의 finally에 작성하여 해당 락이 종료되도록 하여 데드락이 발생하는 것을 방지할 수 있습니다.


lock.isHoldByCurrentThread(): 잠금이 현재 스레드에 의해 유지되고 있는지 확인하여, 맞다면 true, 아니라면 false를 반환합니다.


// 좋아요 버튼을 눌렀을 때
@PostMapping("/posts/{postId}/like")
public ResponseEntity<?> like(@PathVariable("postId") Long postId, Authentication authentication) {

    // Redis 분산 락을 postId에 기반하여 생성
    RLock lock = redissonClient.getLock("post-like-lock:" + postId);

    try {
        // 락을 5초 동안 시도하고, 락을 얻으면 3초 후 자동 해제
        boolean isLocked = lock.tryLock(5, 3, TimeUnit.SECONDS);
        if (isLocked) {
            if (authentication != null && authentication.isAuthenticated()) {
                String username = authentication.getName();
                Optional<User> userOptional = userService.findByUserName(username);

                if (userOptional.isPresent()) {
                    User user = userOptional.get();
                    Optional<Post> postOptional = postService.getPostById(postId);

                    if (postOptional.isPresent()) {
                        Post post = postOptional.get();
                        boolean liked = likeService.like(post, user);
                        Long likeCount = likeService.countByPostId(postId);

                        String postOwnerUsername = postService.getPostOwnerUsername(postId);
                        if (!username.equals(postOwnerUsername)) {
                            notificationService.createNotification(postOwnerUsername, username + "님이 게시글에 좋아요를 눌렀습니다.");
                        }
                        return ResponseEntity.ok().body(new LikeResponse(liked, likeCount));
                    }
                }
            }
            return ResponseEntity.status(HttpStatus.UNAUTHORIZED).body("사용자를 찾을 수 없습니다.");
        } else {
            return ResponseEntity.status(HttpStatus.TOO_MANY_REQUESTS).body("잠금 획득에 실패했습니다. 잠시 후 다시 시도해 주세요.");
        }
    } catch (InterruptedException e) {
        Thread.currentThread().interrupt();
        return ResponseEntity.status(HttpStatus.INTERNAL_SERVER_ERROR).body("잠금 중 오류가 발생했습니다.");
    } finally {
        if (lock.isHeldByCurrentThread()) {
            lock.unlock();
        }
    }


728x90
728x90

스레드(Thread)

  • 프로그램 내에서 작업의 최소 단위로, 하나의 프로세스(프로그램) 내에서 동시에 여러 작업을 처리할 수 있게 해주는 흐름입니다.
  • 예를 들어, 하나의 앱이 프로세스라면, 그 안에서 개별적인 작업들이 각기 독립적으로 실행되는 단위를 스레드라고 합니다.


스레드의 특징 

  • 병렬 처리: 여러 스레드를 통해 작업을 동시에 처리할 수 있어 작업 속도가 향상됩니다.
  • 자원 공유: 같은 프로세스 내에 존재하는 스레드는 메모리와 같은 자원을 공유합니다. 예를 들어, 두 개의 스레드가 같은 데이터에 접근할 수 있습니다.
  • 독립적인 실행 흐름: 각 스레드는 독립적으로 실행되지만, 같은 프로세스 내에서 다른 스레드들과 자원을 공유하며 실행됩니다.

스레드의 예

  • 웹 브라우저에서 예를 들면, 한 스레드는 화면에 텍스트와 이미지를 표시하고, 다른 스레드는 사용자의 클릭이나 입력을 처리하며, 또 다른 스레드는 백그라운드에서 파일을 다운로드하는 식으로 여러 작업이 동시에 이루어질 수 있습니다.


Synchronized와의 관계 

  • 스레드들이 같은 자원을 공유하면서 동시에 접근할 때, 데이터 충돌이 발생할 수 있습니다.
  • 이를 방지하기 위해 Synchronized 키워드를 사용해 특정 메서드나 코드 블록에 Lock을 걸어 한 번에 하나의 스레드만 접근할 수 있도록 상호 배제를 설정할 수 있습니다.


자바의 Synchronized 키워드

  • Synchronized 키워드를 통하여 메서드나 코드 블록에 Lock 을 걸어 스레드 간 상호 배제를 할 수 있습니다.
  • 메서드에 작성할 경우 해당 클래스 인스턴스에 Lock 을 걸고, 코드 블록에 작성할 경우 블록으로 작성된 부분만 Lock 이 걸리게 됩니다.


적용 위치

  • 메서드, 코드 블록
  • 메서드에 적용
    • 클래스 인스턴스에 Lock
  • static 메서드에 적용
    • 클래스에 Lock
    • static synchronized 메서드와 synchronized 메서드의 Lock 은 공유하지 않는다.
  • 메서드의 코드 블록에 적용
    • 인스턴스의 블록 단위에 Lock
    • 동기화 전후에는 Lock 이 적용되지 않기 때문에, 효율적 사용 가능
    • block 에 this 를 명시할 경우 메서드에 붙은 것과 같은 효과
public class Test {
  public void run() {
      // ...

      synchronized (this) {
          // ...
      }

      // ...
  }
}


  • block 에는 객체 인스턴스를 지정하거나 클래스를 지정할 수 있다.
    • static 메서드의 코드 블록에 적용
    • 클래스에 Lock
    • 코드 블록에 this 를 지정할 수 없다.
    • 동기화 순서
    • Thread 의 동기화 순서를 보장하지 않는다.
728x90
728x90

백준에서 처음으로 DFS와 BFS 문제를 접했는데 해설을 자세하게 해볼려고 한다.


문제 링크

1260번: DFS와 BFS


해설

N,M,V = map(int,input().split())

#행렬 만들기
graph = [[0]*(N+1) for _ in range(N+1)]
for i in range (M):
    a,b = map(int,input().split())
    graph[a][b] = graph[b][a] = 1

#방문 리스트 행렬
visited1 = [0]*(N+1)
visited2 = visited1.copy()

#dfs 함수 만들기
def dfs(V):
    visited1[V] = 1 #방문처리
    print(V, end=' ')
    for i in range(1, N+1):
        if graph[V][i] == 1 and visited1[i] == 0:
            dfs(i)

#bfs 함수 만들기
def bfs(V):
    queue = [V]
    visited2[V] = 1 #방문처리
    while queue:
        V = queue.pop(0) #방문 노드 제거
        print(V, end = ' ')
        for i in range(1, N+1):
            if(visited2[i] == 0 and graph[V][i] == 1):
                queue.append(i)
                visited2[i] = 1 # 방문처리

dfs(V)
print()
bfs(V)


1. 행렬 만들기


행렬을 만들 때 자주 사용되는 리스트 컴프리헨션 문법을 사용한다.

graph = [[0]*(N+1) for _ in range(N+1)]
for i in range (M):
    a,b = map(int,input().split())
    graph[a][b] = graph[b][a] = 1
[[0]*(N+1)] 은 N이 3이라면 [[0] * (4)] 이므로 => [[0,0,0,0]]을 출력한다. 
리스트 컴프리헨션을 써주면 [[0,0,0,0], [0,0,0,0], [0,0,0,0], [0,0,0,0]]행렬이 완성된다.

graph =   0 1 2 3 행
	0 0 0 0 0
        1 0 0 0 0
        2 0 0 0 0
        3 0 0 0 0
        열
        
정점의 개수만큼의 행렬을 만들었다면,
이제는 정점 간의 연결을 행렬에 표시해 주어야한다.
만약 '1 2'가 입력된다면 정점1과 정점2가 연결되어있다는 뜻이므로 0을 1로 바꿔준다.

graph[1][2] = graph[2][1] = 1

graph =   0 1 2 3 행
	0 0 0 0 0
	1 0 0 1 0
	2 0 1 0 0
	3 0 0 0 0
	열


2. 방문 리스트 만들기

BFS와 DFS는 스택과 큐를 사용한다. 이때 스택과 큐에 한번 들어갔던 노드는 다시 들어가지 못한다.

즉, 이 노드가 스택과 큐에 들어갔던 적이 있는지 확인할 필요가 있다. 이를 표현하기 위해 정점의 수만큼의 방문 리스트를 만들겠다.

visited1 = [0]*(N+1)
visited2 = visited1.copy()

N이 3이라면, visited1 = [0,0,0,0]
만약 1번 노드가 스택에 들어간 적이 있다면 visited = [0,1,0,0] 이 될 것이다.


3. DFS 함수 만들기 - 재귀 사용

def dfs(V):
    visited1[V] = 1 #방문처리
    print(V, end=' ')
    for i in range(1, N+1):
        if graph[V][i] == 1 and visited1[i] == 0:
            dfs(i)
            
탐색을 시작하는 번호 V부터 탐색을 시작한다.
먼저 V노드가 시작이므로 V를 방문 처리한다. 
예를들어 V=1이라면 위에서 만들어놓은 방문 리스트에서 visited1[1] = 1 로 방문처리하는 것이다.
그러면 visited1 = [0,1,0,0]이 될 것이다.
이는 1번 노드가 스택에 들어간적이 있다는 기록인 것이다.

1번 노드가 방문했으므로 1번 노드를 출력한다.
print(V, end=' ')

이 후 for문을 돌려서 if graph[V][i] == 1로
graph[1][1], graph[1][2], graph[1][3]을 확인해 줄 것이다.
이는 1과 연결된 노드를 찾는 것이다. (위에서 행렬로 연결된 노드들을 1로 표시해두었으므로)

만약 1과 2가 연결돼있다면 graph[1][2] == 1에 True가 될 것이다.
여기서 and visited1[i] == 0으로 2번 노드가 스택에 들어갔던 적이 있는지 확인해주어야 한다.
만약 2번 노드가 스택에 들어간적이 있다면 만들어놓은 방문리스트에서 1값으로 변경되었을 것이다.

즉, 1과 연결된 노드 중 방문기록이 없는 노드를 찾는 코드이다.
if graph[V][i] == 1 and visited1[i] == 0:

1과 연결된 노드 중 방문기록이 없는 노드가 있다면
dfs(i)로 재귀함수를 돌린다.

dfs(2)는 다시 위의 과정을 돌려서 2를 방문처리하고, 2와 연결된 노드를 찾는다.
이렇게 계속 연결된 노드들을 찾아 '깊이우선탐색'을 진행하는 것이다.  


4. BFS 함수 만들기

def bfs(V):
    queue = [V]
    visited2[V] = 1 #방문처리
    while queue:
        V = queue.pop(0) #방문 노드 제거
        print(V, end = ' ')
        for i in range(1, N+1):
            if(graph[V][i] == 1 and visited2[i] == 0):
                queue.append(i)
                visited2[i] = 1 # 방문처리
      
      
bfs는 queue를 이용한다.
탐색 시작 노드 V가 주어진다면
queue = [V] 로 큐에 탐색 노드를 먼저 넣는다.
이 후, 위에서 만들어놓은 방문리스트 visited2[V] = 1로 방문 처리해준다.
V가 1이라면 visited2 = [0,1,0,0]이 될 것이다.
dfs와 같은 원리이다.

이제 while queue: 로 queue에 값이 없을때까지(탐색이 끝날때까지) 반복할 것이다.
먼저 queue.pop(0)을 해준다. 이 코드는 queue에서 0번째 요소를 돌려주고 삭제하라는 것이다.
queue는 선입선출 구조이므로 가장 먼저들어온 0번째 요소부터 빼는 것이다.
그리고 삭제한 요소를 V변수로 돌려받겠다.
위에서 V를 1로 가정했을 때 queue = [1], visited[2] = [0,1,0,0]인 상태이고
여기서 V = queue.pop(0)을 해주면 queue = []이 되고, V = 1이 될 것이다.
1을 뺐으니 1을 출력한다. print(V, end = ' ')

이 후 for문으로 연결된 노드들을 탐색해줄 것이다.
원리는 위에 설명한 dfs와 같다.
V와 연결되고, 방문한 적이 없는 노드가 있다면
큐에 넣어줄 것이다.


bfs과정을 나열해보겠다.
V = 1 // 1번 노드부터 탐색시작
queue = [1] // 방문 노드 저장
visited2[1] = 1 // visited2 = [0,1,0,0]

while문 들어가서,
queue = []
V = 1 // 1출력
for문 들어가서,
노드 1과 2가 연결되고, 노드 2가 방문된적이 없다면
graph[1][2] ==1 and visited2[2] == 0에 해당하므로
queue = [2]
visited2[2] = 1로 방문처리

노드 1과 3이 연결되고, 노드 3이 방문된적이 없다면
queue = [2,3]
visited2[3] = 1로 방문처리
모든 연결 노드 확인 후 for문 반복 끝

queue에 값이 있으므로
while문 탈출 안하고 다시 반복
V = 2 // 2출력
queue = [3]
graph[2][1] == 1 and visited2[2] ==0에 해당하지 않으므로 큐에 다시 넣지 못한다.(2는 1과 연결돼있지만, 1은 이미 큐에 들어간 기록이 있다.)
graph[2][3] == 1 and visited2[2] ==0 역시 마찬가지로 방문기록이 있으므로 false

이 경우 아무것도 추가되지 않고 for문을 빠져나간다.
queue = [3]으로 아직 값이 있으므로 while문 다시 반복
V = 3 
queue = []


5. BFS 함수 더 이해하기

queue는 pop(0)을 통해 먼저 들어온 요소를 뺀다.
선입선출인 큐가 너비우선탐색을 하게하는 핵심이다.

아래와 같이 연결된 노드가 있다고 가정해보자.
(1-2,1-3,1-4,3-5,4-6,6-7 연결)

1 - 2 
  - 3 - 5 
  - 4 - 6 - 7
  
  
queue에는 시작 노드를 먼저 담고 시작한다.
queue = [1]로 시작해서 1을 뺀 후 출력한다.
// queue = []
// 출력: 1
이 후 1과 연결된 2,3,4 가 queue에 담길 것이다.

// queue = [2,3,4]
0 번째 요소 (가장 먼저들어온) 2번 노드를 빼고 출력한다.
// 출력: 1 2
2와 연결된 노드를 확인한다.
2와 연결된 노드가 없다면 추가되지 않는다.

// queue = [3,4]에서
0 번째 요소 3번 노드를 빼고 출력한다.
// 출력: 1 2 3
3과 연결된 노드를 확인한다.
3과 연결된 5가 queue에 담길 것이다.

// queue = [4,5]
0 번째 요소 4번 노드를 빼고 출력한다.
// 출력: 1 2 3 4
4와 연결된 노드를 확인한다.
4와 연결된 6이 queue에 담길 것이다.

// queue = [5,6]
0 번째 요소 5번 노드를 빼고 출력한다.
// 출력: 1 2 3 4 5
5와 연결된 노드를 확인한다.
5와 연결된 노드가 없다면 추가되지 않는다.

// queue = [6]
0 번째 요소 6번 노드를 빼고 출력한다.
// 출력: 1 2 3 4 5 6
6과 연결된 노드를 확인한다.
6과 연결된 7이 queue에 담길 것이다.

// queue = [7]
0 번째 요소 7번 노드를 빼고 출력한다.
// 출력: 1 2 3 4 5 6 7
7과 연결된 노드를 확인한다.
7과 연결된 노드가 없다면 추가되지 않는다.

queue = [] 빈 문자열이므로 while 반복문을 달출한다.
728x90

+ Recent posts